10/3と10/4の「AIアバター型」2本、10/10の「dotちゃん」アニメ1本、10/18の「Kling 4.0 会話ドラマ」1本。何を用意して、どの道具を、どの順番で使ったかを、1本ずつタブに分けてまとめました。どれも撮影も編集ソフトも使っていません。Claude Code に文章で頼んで組み立てています。
| 10/3 撮影してません | 10/4 ほんとの私は、どっち? | 10/10 dotちゃん | 10/18 Kling会話ドラマ | |
|---|---|---|---|---|
| 型 | AIアバターが喋る | AIアバター+本人の声 | 3Dキャラのアニメ | AIの3人が会話するドラマ |
| 長さ | 41秒(1.3倍速) | 53.5秒(1.2倍速) | 34.8秒(1.3倍速) | 65秒(声は1.2倍速) |
| 声 | 自分の声をAIで複製(Gemini) | スマホのボイスメモ | 自分の録音(2回分をつなぐ) | 3人の声を複製(fal.ai MiniMax) |
| 顔・キャラ | 写真+声 → 口が動く動画(fal.ai Kling) | 同じ(2か所だけ) | ユミのイラスト+口の画像5枚を切り替え | ChatGPTで画像 → Kling 4.0で動画 → 口合わせ(fal.ai Kling LipSync) |
| 組み立て | Python(Claude Codeが書く) | Python(Claude Codeが書く) | HyperFrames(Webページを動画にする) | Python+ffmpeg(Claude Codeが書く) |
| 動き | ①②③・波形・タイピングなど | 上下分割・時計・×印など | 3Dの毛並み・ぷよぷよ・付箋・進捗バーなど | カメラの寄り・立ち上がってサングラス・走る・空を飛ぶ |
| お金 | 約240円(喋る動画6本) | 約140円(喋る動画2本) | 0円(すべて手元で作成) | 約2,500円(Kling 約1,500円+fal.ai 約1,000円・試行錯誤込み) |
| ここが難しい | 顔が崩れない写真選び | 録音の間を詰める作業 | 毛の質感と、声に動きを合わせる作業 | 顔・座り方をそろえることと、口合わせ |
お金はAIサービスの従量課金ぶんだけです(1ドル=150円で計算)。ChatGPT・Claude などの月額プランは含めていません。
顔以外ぜんぶAI、という型のリールです。写真1枚と自分の声のお手本から、「喋る私」の動画を作りました。カメラの前には一度も立っていません。
文章で「こういうリールにしたい」と頼むと、参考リールの分解、文字やアニメを描くプログラムづくり、合成、書き出しまで進めてくれます。コマを並べた画像を見て、自分で直すこともします。
自分の写真をもとに、レタッチ・ピンクのマイクを持ったポーズを作りました。ここは本人がChatGPTのアプリで作業しています。
同じ顔のまま背景だけ違う写真を4種類と、走る・タップする「小さい私」の全身3枚。ChatGPTの契約の中で使えるので追加料金なし。
自分の声のお手本(10〜30秒)から声を複製し、台本を1行ずつ「明るく」「ささやくように」など感情の指示つきで読ませました。
10/3以降は有料枠が必要写真1枚と声の音声を渡すと、口が動いて喋る動画になります。6本作って約1.6ドル。使った分だけ払うしくみで、残高の入金は本人がします。
約1.6ドル①②③の番号、動く波形、タイプされる台本などのアニメは、Claude CodeがPythonで1コマずつ描いています。ffmpeg(動画の加工ソフト)で音をまぜ、1.3倍速にして書き出しました。
参考リールの分析、同梱の効果音・フォント、キャプションの言い切りチェック、投稿後の数字の記録に使いました。組み立て本体は使っていません。
真似したい型のリールを保存して、Claude Code に渡します。「何秒に何が出るか」「文字の大きさ・色・位置」を表にしてくれます。今回は「顔だけ本物で、ほかは画像生成と喋る動画AI」という型だと分かりました。
冒頭2秒のフックを先に決めて、残りを組み立てます。今回は「この動画、実は撮影してません」。言い切りすぎていないか、キットのチェックにもかけました。
ChatGPTに自分の写真を渡して、レタッチ・ポーズ(ピンクのマイク)を作ります。手は顔から離して胸の高さにしておくと、次の「喋る動画」で顔が伸びたり崩れたりしにくくなります。
整えた写真をCodexに渡し、顔はそのまま背景だけ変えたものを4種類作ってもらいました。場面が変わって見えるので、同じ人がずっと喋っていても飽きにくくなります。
自分の声のお手本と、AIで複製することへの同意文を録音して渡し、台本を1行ずつ読ませました。行ごとに「ここは驚いて」などの指示がつけられます。
10/3以降、Geminiの声の複製はAPIの有料枠でないと使えなくなりました。いまから作るなら、10/4のように自分で録音するのがいちばん安くて自然です。
写真と声を1組ずつ fal.ai の Kling Avatar に送り、口が動く動画にします。今回は台本を6つに分けて6本。1本あたり30円くらいです。
できた動画は必ずコマで確認します。手が勝手に動いて顔にかかることがあるので、変なところは別の画像に差し替えます。
①②③の番号、動く波形、台本がタイプされていく様子、3つのものが吸い込まれる動き、プロフィールへのズーム。どれも「こういう動きを入れて」と頼むと、PythonでClaude Codeが描きます。
最後に、小さい私が右から走ってきてリンクをタップする演出。Codexで緑の背景の全身画像を3枚(走る2枚・タップ1枚)作り、緑だけ抜いて切り抜きにしました。
1秒ごとのコマを1枚に並べた画像を見て、文字の読みにくさ・顔の崩れを直してから書き出します。動画の中にAI表記は入れず、投稿するときにインスタの「AI情報」ラベルをオンにしました。
キャプションはリールの書き起こしにせず、補足を書きます。翌日に閲覧・保存の数字を記録して、次のリールの参考にしました。
10/3の続編。今回は声を複製せず、スマホのボイスメモで自分の声を録りました。整った「アフター」と、すっぴんで散らかった夜の「ビフォー」を見せる構成です。
録音の切り分け、間詰め、アニメ、合成、書き出しまで。台本の言い回しも一緒に考えました。
約75秒を1回で録音。言い直しがあっても大丈夫。あとで息つぎごとに切って、いいところだけつなぎます。
0円整ったリビングの私と、すっぴん・道着が散らかった夜の私の2枚。本人がアプリで作りました。
空手の会場は本人が撮った本物の動画。買い物・ごはん・お風呂は顔の入らないAI画像にして、ゆっくり寄る動きをつけました。
今回は2か所だけ。1か所はAIが勝手にあごに手を当てたので、その部分だけ場面の画像に差し替えました。
約0.9ドルキャンプの告知バナーをGeminiで動かした動画に。上の崩れた文字はすりガラスのようにぼかして隠し、日付を重ねました。
上下に分かれた画面が広がる冒頭、「19:30」の時計、「今日の投稿 0件」、髪・メイク・撮影に×印など。1.2倍速で書き出し。
台本は本人が作り、冒頭だけClaude Codeと一緒に磨きました。前回のリールを見た人が「続き?」と分かる入り方にしています。
スマホのボイスメモで、台本を最初から最後まで読みます。噛んでも止めずに言い直してOK。録れたファイルをパソコンに送ります。
録音を「息つぎ」で19のブロックに切り分け、言い直しを捨てて、ブロックの間の無音を短くしてつなぎます。これだけでテンポがぐっと良くなります。
ChatGPTで「整ったリビングの私」と「すっぴん・散らかった夜の私」を作ります。同じ人に見えるよう、元の写真を毎回いっしょに渡します。
自分で撮った空手の動画と、Codexで作った「買い物・ごはん・お風呂」の画像。AI画像は顔を入れないようにすると、別人に見える心配がありません。
本物の動画にほかの人が映っていないか確認します。今回は会場にほかの参加者が映っていました。
10/3と同じく fal.ai の Kling Avatar で。全部を喋る顔にしなくても、要所だけで十分「私が話している」感じになります。崩れたところは場面の画像に差し替え。
効果音7か所、BGMは入れず(インスタで付ける)、1.2倍速。コマを並べて確認してから書き出しました。
前回の形を引き継ぎ、告知はタイトルのすぐ下に。本文は書き起こしにせず補足を書きます。
OpenAIの「Dots」を、なんでも投げられる秘書として紹介するリール。ピンクのふわふわ「dotちゃん」が弾んだり、サングラスを上げたり、電球を光らせたりします。撮影ゼロ、編集ソフトもゼロです。
このリールは、動画編集ソフトではなく1枚のWebページとして作り、それを動画に書き出しています。重ねている層はこの3つです。
流れ表づくりから、3Dの毛、口パク、効果音の配置、書き出しまで全部。こちらは文章で「ここでぷるんと出して」「毛をもっとふわふわに」と頼むだけです。
HeyGenが公開している無料の道具。HTML(Webページ)に「何秒から何秒まで何を出すか」を書いておくと、1コマずつ撮影してMP4にしてくれます。プレビュー画面で見ながら直せます。
無料Webページの中で3Dを表示する道具。dotちゃんの3Dモデルを読み込み、毛並み・ぷよぷよ・サングラス上げ・電球をここで足しています。
無料Webページの部品を「0.3秒でポンと拡大」のように動かす道具。付箋が貼られる、リストが1行ずつ出る、進捗バーが伸びる、などはこれです。
無料録音した声を文字起こしして、「どの言葉が何秒に出るか」を調べます。HyperFrames に入っている whisper.cpp(large-v3)を使いました。この秒数に合わせて文字や動きを出しています。
無料(手元で動く)録音の間を詰める、効果音7種類を音の波から作る、背景の画面録画を早送りする、最後に1.3倍速にする。動画と音の下ごしらえは全部これ。
無料ユミのキャラの「あ・い・う・え・お」の口の画像5枚とウインクは、本人がChatGPTで作成。口元だけ切り出して重ねています。
背景の画面録画に映った人の名前を、Mac に入っている文字認識で全コマから探し、625コマをぼかしました。ぼかした後にもう一度読ませて、読めるコマが0件なのを確認。
無料Remotion は使っていません。Remotion はリールキット(撮影した動画の編集)で使っている道具で、撮影素材なしのアニメは HyperFrames、と使い分けています。
元の3Dモデルは、つるんとしたピンクのハートです。毛は1本ずつ植えているわけではなく、同じ形を少しずつ大きくして34枚重ね、外側ほど穴をたくさんあけることで、毛が生えているように見せています。3Dの世界では「シェルファー(殻の毛)」と呼ばれる昔からある方法です。
本番では「もっと大きく、アップで」「最後はもっと動き回ってぷよぷよして」の声を受けて、体を1.3〜1.6倍に、揺れを約1.5倍にし、最後にジャンプ・回転・ダンスを足しました。
どの動きも「何秒のときはこの姿勢」と時間だけで決まるように作っています。HyperFrames が1コマずつ撮影するとき、途中から再生しても同じ絵になるようにするためです。
dotちゃんの3Dモデルは、ChatGPTのDots紹介ページの中で使われているファイル(.glb、約0.5MB)を取り込んだものです。入っているのは体・サングラス・骨だけで、ぷよぷよの動きや毛はこちらで足しました。最初は「権利が心配なので使わない」方針でしたが、途中で使う方向に変わり、OpenAIのガイドライン(形を変えてはいけない等)の話が出たのは完成した後でした。最終的に本人が判断して、キャプションに「OpenAIとは関係ありません」と1行入れて投稿しています。他社のキャラや素材は、作り始める前に使っていいかを確認してください。
参考にしたXの説明アニメを2.5秒ごとに分解し、「問いかけ → 困りごと → 番号つきの説明 → 結果 → 最後のお願い」という流れと「濃いグレー+白+強調1色」の配色だけを借りて、中身をDotsの話に入れ替えました。
「0〜2秒:あれもやらなきゃ(付箋が貼られる)」のように、秒・画面の言葉・動きの3列の表にします。ここを会話で確定させてから作り始めると、やり直しが少なくなります。
いきなり本編を作らず、まずdotちゃんだけが動く4〜8秒の試作を作りました。毛のふわふわ具合、弾み方、サングラスを上げる動きを、試作4本で詰めています(上の比較)。
流れ表のセリフを、スマホで読んで録音します。今回は2回に分けて録り、あとから追加のセリフ(「私はdotちゃんって名付けたよ」など)と、最後のお願いも録り足しました。
Whisperで文字起こしし、無音のところで15個に区切って、「このセリフは何秒から何秒」を割り出します。0.25秒より長い無音は0.2秒に縮めてつなぎ直し、48秒の録音が41秒になりました。
アニメは先に「だいたいの秒数」で作っておき、声が入ったら声の本当の秒数に合わせて全体を伸び縮みさせます。言葉ぴったりに合わせたいところだけ、秒数を直接書き込みます。
声の大きさを1/30秒ごとに測って、口の画像を切り替えます。大きいときは「あ」、中くらいは「え・お・い」を順番に、小さいときは「う」、無音なら閉じた口。同じ口を2コマ以上続けて、ちらつきを防ぎます。台本どおりに口を動かすより、声に合わせたほうが自然でした。まばたきは不採用で、最後だけウインク。
口の画像は全身を描き直すと顔が別人になりやすいので、口元だけを切り出して重ねるのが確実です。5枚とも顔の位置がそろっているか、先に確認します。
本人がdotちゃんとやりとりした画面録画(6分37秒)から、会話が動いている2分53秒だけを残して約3.8倍速に。キーボードと入力欄は切り落とし、ぼかして暗くしました。明るさは3案から本人が選んでいます。
画面に映っていた人の名前は、Macの文字認識で全コマから探してぼかしました。ぼかした後にもう一度読ませて、読めるコマが0件なのを確認しています。
流れ表どおりに、付箋が次々に貼られる → 画面が埋まる → dotちゃんがぷるんと登場 → 7つのToDoが1行ずつ出る → 7本の進捗バーが同時に伸びる → ツール名の札がdotちゃんに吸い込まれる、と組みます。
ポン・カチッ・シュッ・ドン・キラキラ・チーン・ぼよんの7種類を、素材を探さずffmpegで音の波から作りました。付箋が貼られるたびにポン、リストが出るたびにカチッ、と動きに合わせて全部で65回鳴らしています。
HyperFrames のプレビュー画面で再生しながら、気になるところを言葉で伝えて直します。何版も書き出して(v1〜v6)、速さも1.3倍・1.5倍を見比べました。実際に出した直しの言葉はこんな感じです。
細かい直し方を知らなくても、見て感じたことをそのまま言えば伝わります。
最初は「秘書とコメントしてね」で終わる予定でしたが、「いろんなタイプのリールを作ってみたい方はフォローしてね」に変更。自分のインスタのプロフィール画面を見せて、指がフォローボタンを押す → 「フォロー中」になる動きにしました。
1秒39コマで書き出してから1.3倍速にすると、ちょうど1秒30コマ(34.8秒)になります。声の高さは変わりません。スマホに送るときにファイルが大きくて途中で止まったので、AirDropで送りました。
本編と同じしくみで、dotちゃん入りの静止画を書き出します。インスタの一覧で見える真ん中(縦3:4)に文字を収めるのがポイント。4案から、サングラスを上げたDを選びました。
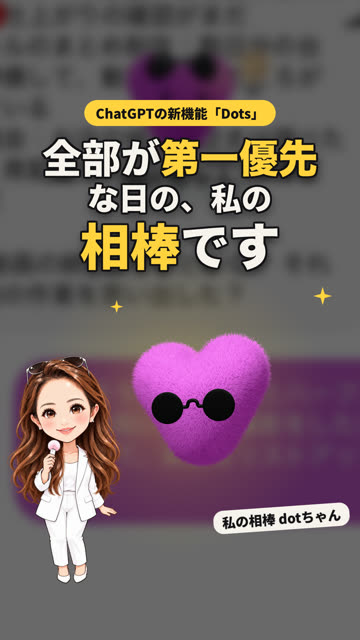


キャプションにはキャンプの告知と、「Dotsは個人の感想で、OpenAIとは関係ありません」の注記を入れました。BGMはインスタで小さめに付けます。
かかった時間の目安:分解と流れ表 約1時間(10/9)→ 本制作 約5時間(10/10)→ 背景・最後の画面・キャプション 約3時間(10/13)→ 表紙 数分。書き出しは1回あたり1〜2分です。
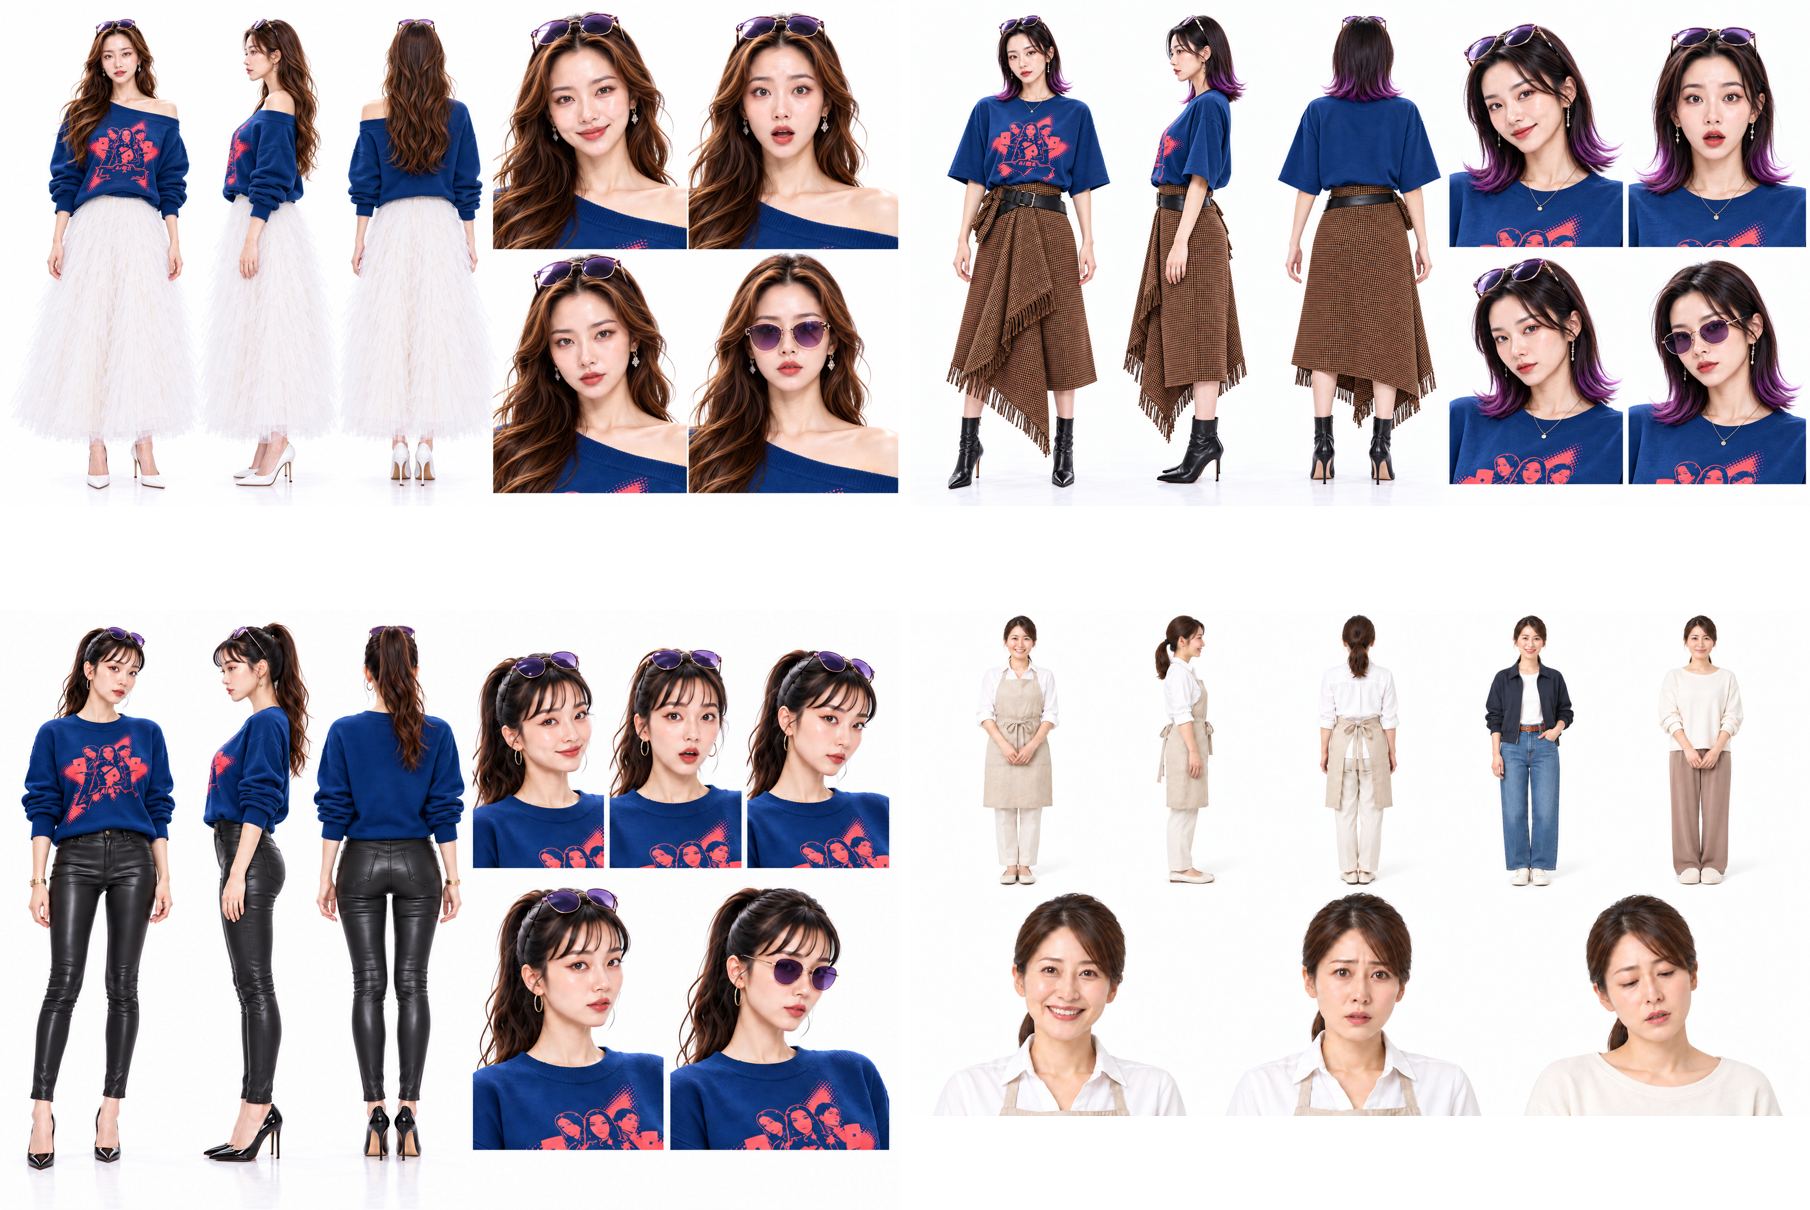
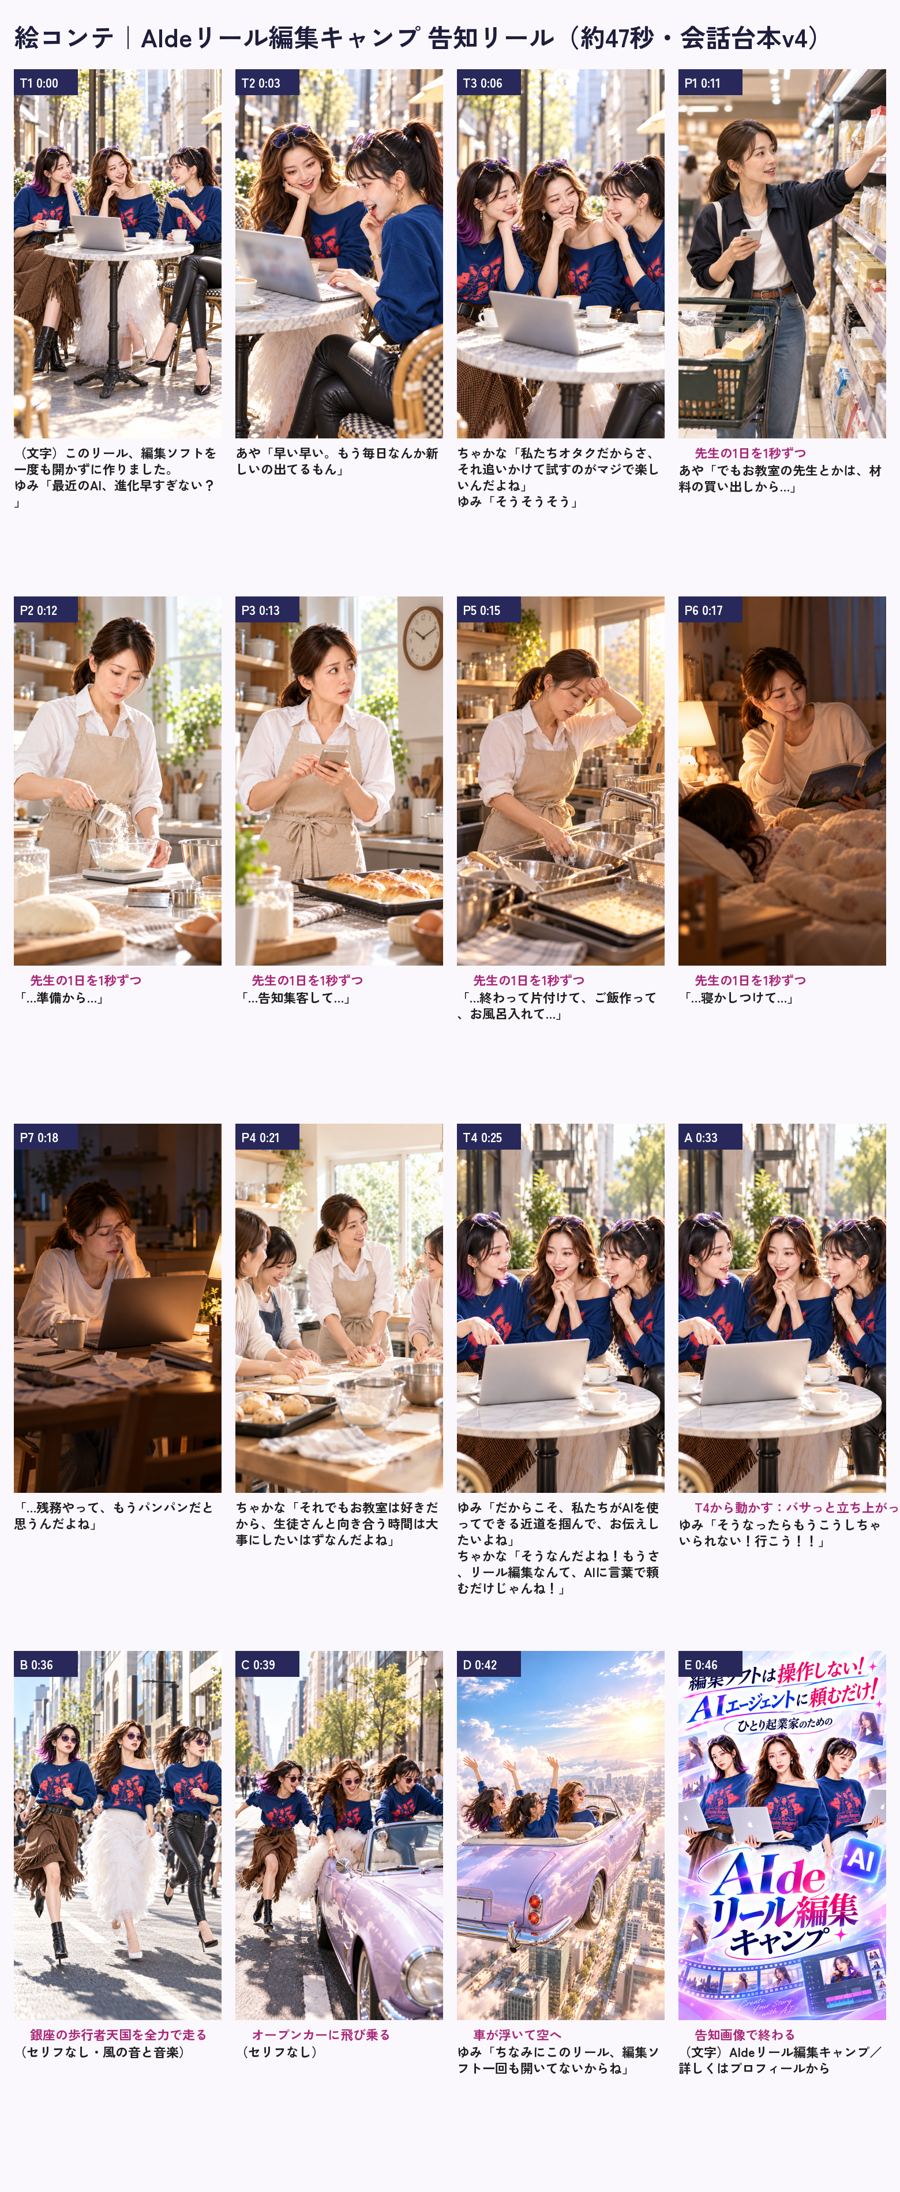
AIdeリール編集キャンプの告知リールです。銀座のカフェで3人が「AIの進化、早すぎない??」と雑談して、「行こう!!!」で立ち上がり、銀座を走ってオープンカーで空へ。映像は Kling 4.0、声は3人の声から作ったクローン音声、口の動きも日本語に合わせています。
台本づくり、Kling への依頼、声と口合わせ、効果音、テロップ、組み立てまで、全部文章で頼みました。Kling は MCP(AIどうしをつなぐしくみ)で Claude Code から直接動かしています。
画像を1枚渡すと、それを最初のコマにして動画にしてくれます。「最初・途中・最後のコマ」を画像で渡すと、3人の引きから1人ずつに寄るカメラの動きも作れます。1080p・5秒で67クレジット。
Proプラン(3,000クレジット/月)3人と「パン教室の先生」のキャラクターシート、各シーンの最初のコマの画像を作りました。ここは本人が ChatGPT のアプリで作業しています。
ゆみは以前作った声の複製、あや・ちゃかなはミーティングの録画から声を切り出して複製しました(本人のOKをもらってから)。セリフごとにテンションや速さを指定できます。
複製1人 約1.5ドルKling で作った映像と声を渡すと、口の動きを声に合わせてくれます。5秒の映像で約0.07ドル、1本3分ほど。
5秒 約0.07ドルサングラスの「カチャッ」は効果音ラボ(商用無料・表記不要)。エンジンの「ブォン」は fal.ai で作りました。足音・笑い声は Kling が映像と一緒に作った音をそのまま使っています。
Claude Code が組み立て用のプログラムを書きました。テロップはイタリック調・字間を詰めたゴシックに、やわらかい影。セリフの時間に合わせて自動で出し入れしています。
最初はこれだけでした。台本も構成も決まっていなくて大丈夫です。
このとき、作業フォルダの中にキャンプのLPのファイルが入っていたので、Claude Code が自分で見つけて読み、告知の中身(誰向けか・何が学べるか・料金)をつかんでから話を進めてくれました(ユミからは渡していません)。台本に入れる数字や内容は、LPに書いてあることだけを使います。
告知したいもののLP・チラシ・資料を作業フォルダに入れておくと、AIが自分で読んで中身をつかんでくれます。「このLPを読んで」と一言添えるとさらに確実です。
Claude Code が1回に1〜2個ずつ、選択肢つきで質問してくれます。答えるだけで、だんだん中身が固まっていきます。
途中から、ユミが思いついたことを少しずつ話しました(音声入力でOK)。
ネタは「自分たちに本当にあった会話」と「届けたい人の1日」。AIが作り話をするのではなく、自分の言葉をAIが拾って並べる形にすると、嘘っぽくなりません。
Claude Code が話をつないで台本の下書きを出します。自分が補った部分は「ここは私が足しました」と教えてくれるので、違うところだけ直します。
ChatGPT に告知画像を渡して、1人1枚のシート(全身の正面・横・後ろ、顔の表情3つ、サングラスあり・なし)を作りました。パン教室の先生(実在しない人物)も1枚。これがあると、カットが変わっても顔と服がそろいます。
シートを添付して、各カットの「最初のコマ」を ChatGPT で14枚。Claude Code がセリフと秒数を添えて絵コンテにまとめます。動画にする前に流れを確かめられるので、Kling のクレジットを無駄にしません。
アップの画像は、引きの画像と座り方をそろえる(横並びなら手前に人を入れない)。そろっていないと、カットが変わったときに位置関係がおかしく見えます。頬杖も「つかない」と書いておくと、ポーズがばらけて会話らしくなります。
3人の声の複製で、セリフを1行ずつ読ませます。テンション高め・1.2倍速。気になる行だけ何度でも作り直せます。
fal.ai の登録から声の複製・読み上げまでの手順は、声の複製でリールのセリフを作るにまとめています。
シーンの画像を Kling に渡して動画にします。冒頭は「3人の引き → ゆみ」をひと続きのカメラの動きで、会話は話す人のアップに切り替え、出動は「立ち上がってサングラス → 銀座を走る → オープンカー → 空へ」。
縦横比は必ず「9:16」と書く。書かなかったときに横長の動画が出てきて、クレジットを無駄にしました。
Kling の映像と声を fal.ai の Kling LipSync に渡して合体させます。Kling だけで声を渡しても口は合いませんでした。
口合わせは、画面に顔が1つのアップが確実。3人が同じ大きさで映っていると、誰の口が動くかわかりません。
走る足音、オープンカーのエンジン「ブォン」、サングラスの「カチャッ」。映像と一緒に聞き比べて選びました。
Kling が作った音には「ポカッ」という当たり音が混ざることがあります。AIで作る効果音は「サングラスの音」のような具体的な音が苦手でした。
曲は投稿するときにインスタで付けます(会話が聞こえるよう、音楽は小さめ)。AIで作った人物と声なので、「AI情報」のラベルをオンにします。
「キャラシート」とコメントしてくれた人には、DMで公式LINEの登録先を送り、LINEのあいさつメッセージでプレゼントページ(キャラクターシートの作り方)を届けます。
| なに | 使った量 | 金額の目安 |
|---|---|---|
| Kling 4.0(映像) | 1,143クレジット(完成版に使ったのは約730) | 約1,500円 |
| fal.ai(声の複製2人・読み上げ約130回・口合わせ約9本・BGMと効果音) | — | 約1,000円 |
| ChatGPT(キャラクターシート・場面の画像) | シート4枚+場面14枚ほど | 0円(いつものプランの範囲) |
| 効果音ラボ(サングラスの音) | 1つ | 0円 |
| 合計 | 約2,500円 |
1ドル=150円で計算。Kling は Pro プラン(月約26ドル・3,000クレジット)で、残りのクレジットは同じ月の次の動画に使えます。fal.ai の金額は作った数からの見積もりです(BGMを作るAIの単価は未確認)。
初めての1本は試行錯誤込みでこの金額。手順が固まった次からは、1本1,000〜1,500円が目標です。
| つまずき | 原因 | 次はこうする |
|---|---|---|
| 横長の動画が出てきた | 縦横比を書かなかった | 毎回「9:16」と書く |
| 日本語の口の動きが合わない | Kling が声の中身を読み違えた | 口合わせは fal.ai の Kling LipSync で。顔が1つのアップで作る |
| アップと引きで3人の位置がおかしい | アップは向かい合わせ、引きは横並びだった | アップも引きと同じ並び・座り方で作る |
| 「AIで」が「愛で」に聞こえる | 読み上げのクセ | 「AIを」の形にする。「、」は取る。疑問は「??」 |
| 声に「サーッ」という雑音 | 音を強く圧縮しすぎた | 元の音から作り直し、雑音を取る処理は軽めに |
| 「ポカッ」という音が混ざる | Kling が映像と一緒に作った音 | その場面の音は使わない |
| AIの効果音が合わない | 「サングラスの音」のような具体的な音が苦手 | 効果音ラボ(商用無料・表記不要)で探す |
| fal.ai がエラーで止まる | 同時にいくつも頼んだ | 1つずつ順番に頼む |
| 最後の案内が服を隠した | 大きな枠で出した | 画面のいちばん下に小さく。余白も少なめ |
かかった時間の目安:台本と画像づくり 約半日 → 声・Kling・口合わせ・組み立て・直し 約半日(どちらも2026-10-18)。書き出しは11回、Kling で作った動画は23本(完成版に使ったのは11本)、声の読み上げは約130回。